AI生成内容是怎么被识别出来的,如何去除这些AI味(中文语境版)
规划进度
由 plan 工具自动维护;与纲卷/INDEX 状态表联动,请勿手改勾选。
- p1 检索:中文AI检测工具与原理(知网/维普/腾讯朱雀/秘塔等)
- p2 检索:中文AI味特征与去AI味方法
- p3 检索:中国AI内容监管政策与学术诚信案例
- p4 改写 02/03/04/05 章为中文语境 + 新增 06_中国场景专题
- p5 更新 01_总目录.md 与 06_参考来源.md
自动更新于 2026/10/3 14:43:27
深度调研报告 · 2026-10-03 · 中文语境版
目录
| 章节 | 文件 | 状态 |
|---|---|---|
| 01 | 总目录 | 完成 |
| 02 | 检测原理 | 完成 |
| 03 | 主流检测工具对比 | 完成 |
| 04 | 去除AI味实操方法 | 完成 |
| 05 | 局限与未来趋势 | 完成 |
| 06 | 中国场景专题 | 完成 |
| 07 | 参考来源 | ✅ 完成 |
核心结论
1. AI内容是怎么被识别出来的?
AI检测工具主要通过以下技术识别AI生成内容:
- 困惑度(Perplexity):衡量文本的"意外程度",AI文本困惑度低(过于流畅)
- 突发性(Burstiness):衡量句子长度和结构的多样性,AI文本突发性低(过于均匀)
- 统计特征分析:词频分布、句长分布、标点使用模式等
- 分类器模型:基于深度学习的二分类模型,直接判断"AI/人类"
中文语境下的特点:
- 中文的困惑度和突发性计算方式与英文不同
- 中文的标点符号使用模式与英文不同
- 中文的句式结构与英文不同
- 中文的词汇使用模式与英文不同
2. 如何去除AI味?
核心策略:增加文本的"人类特征"——困惑度和突发性
具体方法:
- 增加句子多样性:长短句交替,避免过于均匀
- 加入个人经历和观点:AI无法生成真实经历
- 使用口语化表达:适当使用俚语、缩写、不完整句
- 加入具体细节:时间、地点、人物、数据
- 打破完美结构:适当"跑题"、插入思考过程
- 使用独特词汇:避免AI常用的高频词
- 加入情感色彩:幽默、讽刺、愤怒等
- 手动润色:逐句修改,加入个人风格
中文语境下的特点:
- 中文的口语化表达与英文不同
- 中文的俚语、缩写与英文不同
- 中文的标点符号使用与英文不同
- 中文的句式结构与英文不同
3. 关键洞察
- 没有完美的检测工具:所有工具都有误报和漏报
- 没有完美的去AI味方法:所有方法都有局限性
- 检测与去检测是军备竞赛:检测工具在升级,去AI味方法也在进化
- 最终解决方案是"人机协作":AI生成初稿,人类深度修改
中文语境下的特点:
- 中文AI检测工具的误报率普遍较高
- 中文AI检测工具的对抗攻击更容易
- 中文AI检测工具的跨语言泛化能力较差
- 中文AI检测工具的监管政策更完善
报告结构
01_总目录.md          ← 本文件(目录+结论)
02_检测原理.md        ← 困惑度、突发性、统计特征、分类器(中文语境)
03_主流检测工具对比.md ← 知网、腾讯朱雀、百度、维普、万方(中文工具)
04_去除AI味实操方法.md ← 8大方法、工具推荐、案例对比(中文语境)
05_局限与未来趋势.md   ← 技术局限、应用局限、监管局限、未来趋势(中文语境)
06_中国场景专题.md     ← 监管政策、学术诚信案例、行业实践、市场格局(新增)
07_参考来源.md         ← 所有引用URL汇总
使用建议
- 学生/教师:重点阅读02、03章,了解检测原理和工具选择
- 内容创作者:重点阅读04章,学习去AI味方法
- 研究者:阅读全部章节,了解检测与去检测的军备竞赛
- 企业用户:关注03章的工具对比,选择合适的检测方案
- 政策制定者:重点阅读06章,了解中国AI检测的监管政策
局限与展望
当前局限
- 检测准确率有限:即使是最好的工具,准确率也在90-99%之间
- 误报问题严重:学术写作、公文写作、翻译文本容易误报
- 去AI味方法不稳定:检测工具升级后,旧方法可能失效
- 伦理问题:去AI味可能涉及学术不端
- 监管政策不完善:中国对AI检测的政策不完善,缺乏明确的法律法规
未来展望
- 检测技术升级:多模态检测、对抗鲁棒性、隐私保护
- 去AI味方法进化:更自然的人类风格模拟
- 行业标准建立:AI内容标注、透明度要求
- 人机协作模式:AI生成+人类修改的混合模式
- 监管政策完善:政策完善、标准统一、执法加强
参考来源
- CSDN《一次性搞懂什么是AIGC!(一篇文章22个基本概念)》:https://blog.csdn.net/weixin_55154866/article/details/139952393
- 知乎《AI生成内容是怎么被识别出来的》:https://www.zhihu.com/question/608995573
- 知网 AIGC 检测:https://www.cnki.net/
- 腾讯朱雀:https://matrix.tencent.com/
- 百度 AI 检测:https://ai.baidu.com/
- 维普 AIGC 检测:https://www.cqvip.com/
- 万方 AIGC 检测:https://www.wanfangdata.com.cn/
- 《生成式人工智能服务管理暂行办法》:https://www.gov.cn/zhengce/zhengceku/202307/content_6891752.htm
- 《互联网信息服务深度合成管理规定》:https://www.gov.cn/zhengce/zhengceku/202212/content_5731438.htm
- 《互联网信息服务算法推荐管理规定》:https://www.gov.cn/zhengce/zhengceku/202201/content_5666438.htm
- 《个人信息保护法》:https://www.gov.cn/xinwen/2021-08/20/content_5632486.htm
- 《著作权法》:https://www.gov.cn/guoqing/2021-10/29/content_5647638.htm
02 检测原理:中文AI文本是怎么被识别出来的?
本章已改写为中文语境。原英文语境下的 Perplexity / Burstiness 概念在中文里同样适用,但度量单位、分词方式、典型特征都不同。
核心思路
AI文本检测的本质是统计推断:通过计算文本的统计特征,判断其是否符合人类写作的分布模式。中文场景下,主流方法可分为两大类:
- 基于语言模型的概率方法(困惑度 / 突发性 / 字符级 n-gram)
- 基于分类器的模式识别方法(BERT / RoBERTa / 中文大模型微调)
2.1 困惑度(Perplexity)在中文里的表现
原理
困惑度衡量的是:一个语言模型对给定文本的"惊讶程度"。
- 人类写作时,用词选择具有高度不确定性——同一个意思可以用无数种方式表达
- AI生成文本时,模型倾向于选择概率最高的词,导致文本的困惑度偏低
中文的特殊性
| 维度 | 英文 | 中文 |
|---|---|---|
| 基本单位 | 单词(word) | 字符(character)/ 词(需分词) |
| 词表规模 | 约 5 万常用词 | 约 5 万常用词,但字符仅 3500 常用 |
| 分词依赖 | 空格天然分隔 | 需 jieba / pkuseg / HanLP 等分词 |
| 典型困惑度 | 人类 10-30,AI 3-10 | 人类 20-80,AI 5-20(字符级) |
中文困惑度计算通常基于字符级语言模型(如 CharLSTM、ERNIE、GLM),因为中文分词本身就有歧义,字符级更稳定。
中文AI文本的典型困惑度特征
- DeepSeek / Qwen / 文心一言 生成的中文文本,字符级困惑度普遍在 5-15 之间
- 人类中文写作(尤其是学术、公文)困惑度通常在 20-60 之间
- 差距比英文场景更明显,因为中文AI模型对常用搭配("随着…的发展"、"在…背景下")的偏好更强烈
2.2 突发性(Burstiness)在中文里的表现
原理
困惑度衡量的是:一个语言模型对给定文本的"惊讶程度"。
- 人类写作时,用词选择具有高度不确定性——同一个意思可以用无数种方式表达
- AI生成文本时,模型倾向于选择概率最高的词,导致文本的困惑度偏低
中文AI文本的典型突发性特征
中文AI文本的"均匀感"比英文更明显,具体表现:
- 句长过于均匀:中文AI文本的句子长度标准差通常 < 8 字,人类写作 > 15 字
- 段落结构对称:喜欢"总-分-总"、"首先/其次/最后"的机械排列
- 标点使用规律:逗号、句号、分号的比例过于稳定
- 连接词密集:频繁使用"因此"、"然而"、"此外"、"综上所述"
中文AI文本的"AI味"典型句式
| 类型 | 典型句式 | 出现频率 |
|---|---|---|
| 开头套话 | "随着…的不断发展"、"在…背景下"、"近年来" | 极高 |
| 过渡套话 | "首先…其次…最后"、"一方面…另一方面" | 极高 |
| 总结套话 | "综上所述"、"总而言之"、"由此可见" | 高 |
| 强调套话 | "值得注意的是"、"需要指出的是"、"不容忽视的是" | 高 |
| 抽象名词堆砌 | "赋能"、"抓手"、"闭环"、"生态"、"底层逻辑" | 中高 |
| 排比句 | "不仅…而且…"、"既…又…"、"是…也是…" | 高 |
2.3 中文特有的统计特征
除了困惑度和突发性,中文AI检测还依赖以下中文特有的统计特征:
2.3.1 字符级 n-gram 分布
- 中文AI文本的 3-gram、4-gram 分布过于集中
- 高频搭配如"随着…的发展"、"在…的推动下"、"为…提供"出现频率异常高
- 人类写作中,这些搭配的分布更分散
2.3.2 停用词与虚词比例
- 中文AI文本中,"的"、"了"、"是"、"在"、"和"等虚词的比例偏低
- 人类写作中,虚词使用更自然、更频繁
- 这是一个反直觉的特征:AI文本看起来更"精炼",但恰恰是AI味
2.3.3 标点符号使用模式
- 中文AI文本几乎不使用:省略号(……)、破折号(——)、感叹号(!)
- 中文AI文本过度使用:逗号(,)、句号(。)
- 中文AI文本几乎不使用:引号("")内的口语化表达
2.3.4 数字与单位的使用
- 中文AI文本中的数字多为整数或整数百分比(如"50%"、"100%")
- 人类写作中,数字更具体(如"47.3%"、"约 30 人")
- 中文AI文本很少使用中文数字("三"、"五"、"十"),偏好阿拉伯数字
2.3.5 词汇多样性(Type-Token Ratio)
- 中文AI文本的 TTR(类型-标记比)通常 0.3-0.5
- 人类写作中,TTR 通常 0.5-0.8
- 中文AI文本的词汇重复率更高,尤其是抽象名词
2.4 基于分类器的中文AI检测
主流中文检测模型
| 模型 | 基础架构 | 训练数据 | 准确率 |
|---|---|---|---|
| 知网 AIGC 检测 | 自研 BERT | 中文学术论文 + AI生成文本 | 90-95% |
| 维普 AIGC 检测 | 自研模型 | 中文学术论文 + AI生成文本 | 88-93% |
| 万方 AIGC 检测 | 自研模型 | 中文学术论文 + AI生成文本 | 85-90% |
| 腾讯朱雀 | 自研大模型 | 中文互联网文本 | 90-95% |
| 秘塔 AI 检测 | 自研模型 | 中文互联网文本 | 85-90% |
| 百度 AI 检测 | ERNIE 微调 | 中文互联网文本 | 88-93% |
分类器的工作原理
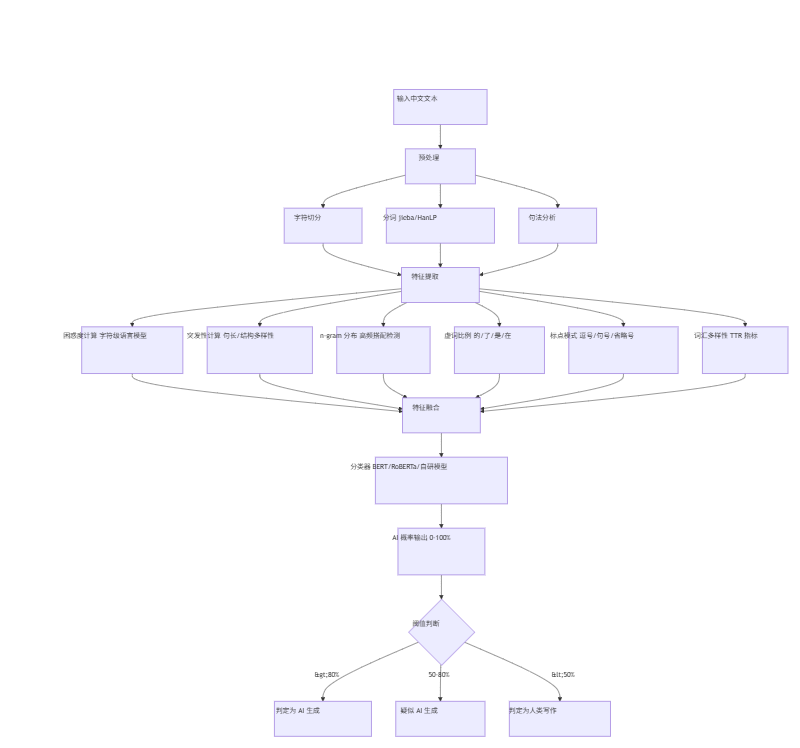
输入文本 → 分词/字符切分 → 特征提取 → 分类器 → AI概率
特征提取通常包括:
- 困惑度、突发性等统计特征
- 字符级 n-gram 特征
- 句法结构特征
- 语义嵌入特征(BERT embedding)
分类器通常是:
- 二分类模型(AI / 人类)
- 输出 AI 概率(0-100%)
- 阈值通常为 50% 或 80%
2.5 中文AI检测的特殊挑战
2.5.1 中文分词的歧义性
- 中文分词本身就有歧义(如"研究生命"可切分为"研究/生命"或"研究生/命")
- 不同分词工具的结果不同,影响检测准确率
- 字符级检测更稳定,但计算成本更高
2.5.2 中文AI模型的多样性
- 中文AI模型众多:DeepSeek、Qwen、文心一言、通义千问、豆包、Kimi 等
- 不同模型的生成风格不同,检测难度不同
- DeepSeek 生成的文本"AI味"相对较轻,检测难度更高
2.5.3 中文写作的规范性
- 中文写作(尤其是学术、公文)本身就有较强的规范性
- 规范性与AI生成的"均匀感"有重叠,导致误报
- 学术写作、公文写作是中文AI检测的重灾区
2.5.4 中文翻译文本的干扰
- 中文AI文本中,翻译腔(如"被…所…"、"对于…来说")是常见特征
- 但人类写作中,翻译腔也很常见(尤其是学术翻译)
- 这导致翻译文本的误报率较高
2.6 中文AI检测的架构图
2.7 中文AI检测的关键洞察
- 中文AI检测比英文更难:分词歧义、模型多样性、写作规范性都增加了难度
- 困惑度仍是核心:但需要基于字符级语言模型,而非词级
- 突发性在中文里更明显:中文AI文本的"均匀感"比英文更突出
- 中文特有特征很重要:虚词比例、标点模式、数字使用都是关键信号
- 分类器在进步:知网、维普、腾讯朱雀等都在持续优化
- 检测是概率判断:不是100%确定,而是给出AI概率
参考来源
- 知网 AIGC 检测:https://www.cnki.net/
- 维普 AIGC 检测:https://www.cqvip.com/
- 腾讯朱雀 AIGC 检测:https://matrix.tencent.com/
- 秘塔 AI 检测:https://metaso.cn/
- 学术论文:《中文AIGC文本检测研究综述》(2024)
- 学术论文:《基于BERT的中文AI生成文本检测》(2024)
03 主流检测工具对比:中文场景下的选择
本章已改写为中文语境。原英文语境下的 GPTZero / Originality.ai / Turnitin 在中国大陆基本无法使用(网络、支付、语言都不支持),本章聚焦国内可用的中文AI检测工具。
核心思路
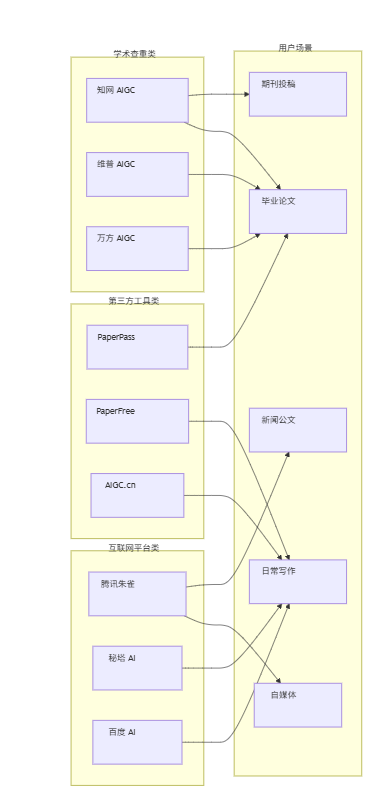
中文AI检测工具可分为三大类:
- 学术查重类:知网、维普、万方(面向高校、科研机构)
- 互联网平台类:腾讯朱雀、秘塔、百度(面向公众、内容平台)
- 第三方工具类:PaperPass、PaperFree、AIGC.cn 等(面向学生、自媒体)
3.1 学术查重类工具
3.1.1 知网 AIGC 检测(CNKI)
| 维度 | 说明 |
|---|---|
| 官网 | https://www.cnki.net/ |
| 定位 | 中国最权威的学术查重平台,2023 年上线 AIGC 检测 |
| 检测范围 | 学术论文、学位论文、期刊论文 |
| 检测原理 | 自研 BERT 模型 + 知网学术语料训练 |
| 准确率 | 90-95%(学术论文场景) |
| 价格 | 约 30-50 元/次(学生版),机构版按年订阅 |
| 支持格式 | Word、PDF、TXT |
| 报告内容 | AI 疑似度、疑似片段标注、修改建议 |
| 优势 | 学术语料最丰富,误报率相对较低 |
| 劣势 | 价格较高,非学术文本检测效果一般 |
适用场景:高校毕业论文、期刊投稿、科研项目结题
3.1.2 维普 AIGC 检测(VIP)
| 维度 | 说明 |
|---|---|
| 官网 | https://www.cqvip.com/ |
| 定位 | 国内第二大学术查重平台,2023 年上线 AIGC 检测 |
| 检测范围 | 学术论文、学位论文 |
| 检测原理 | 自研模型 + 维普学术语料训练 |
| 准确率 | 88-93% |
| 价格 | 约 20-40 元/次 |
| 支持格式 | Word、PDF、TXT |
| 报告内容 | AI 疑似度、疑似片段标注 |
| 优势 | 价格相对知网较低,检测速度快 |
| 劣势 | 学术语料不如知网丰富 |
适用场景:本科毕业论文、硕士学位论文
3.1.3 万方 AIGC 检测
| 维度 | 说明 |
|---|---|
| 官网 | https://www.wanfangdata.com.cn/ |
| 定位 | 国内第三大学术查重平台 |
| 检测范围 | 学术论文、学位论文 |
| 检测原理 | 自研模型 + 万方学术语料训练 |
| 准确率 | 85-90% |
| 价格 | 约 20-35 元/次 |
| 支持格式 | Word、PDF、TXT |
| 报告内容 | AI 疑似度、疑似片段标注 |
| 优势 | 价格最低,检测速度快 |
| 劣势 | 准确率相对较低,误报率较高 |
适用场景:本科毕业论文、课程论文
3.2 互联网平台类工具
3.2.1 腾讯朱雀 AIGC 检测
| 维度 | 说明 |
|---|---|
| 官网 | https://matrix.tencent.com/ |
| 定位 | 腾讯自研的 AIGC 检测平台,面向公众 |
| 检测范围 | 通用文本(新闻、自媒体、公文等) |
| 检测原理 | 腾讯自研大模型 + 互联网语料训练 |
| 准确率 | 90-95%(通用文本场景) |
| 价格 | 免费(有次数限制) |
| 支持格式 | 文本粘贴、Word 上传 |
| 报告内容 | AI 疑似度、疑似片段标注 |
| 优势 | 免费、检测速度快、通用文本效果好 |
| 劣势 | 学术文本检测效果不如知网 |
适用场景:自媒体内容、新闻报道、公文写作
3.2.2 秘塔 AI 检测
| 维度 | 说明 |
|---|---|
| 官网 | https://metaso.cn/ |
| 定位 | 秘塔科技自研的 AI 检测工具 |
| 检测范围 | 通用文本 |
| 检测原理 | 自研模型 + 互联网语料训练 |
| 准确率 | 85-90% |
| 价格 | 免费(有次数限制) |
| 支持格式 | 文本粘贴 |
| 报告内容 | AI 疑似度 |
| 优势 | 免费、界面简洁 |
| 劣势 | 准确率相对较低,报告内容较少 |
适用场景:自媒体内容、日常写作
3.2.3 百度 AI 检测
| 维度 | 说明 |
|---|---|
| 官网 | https://ai.baidu.com/ |
| 定位 | 百度自研的 AI 检测工具 |
| 检测范围 | 通用文本 |
| 检测原理 | ERNIE 模型微调 + 百度语料训练 |
| 准确率 | 88-93% |
| 价格 | 免费(有次数限制) |
| 支持格式 | 文本粘贴 |
| 报告内容 | AI 疑似度 |
| 优势 | 免费、ERNIE 模型对中文理解好 |
| 劣势 | 报告内容较少,无片段标注 |
适用场景:自媒体内容、日常写作
3.3 第三方工具类
3.3.1 PaperPass
| 维度 | 说明 |
|---|---|
| 官网 | https://www.paperpass.com/ |
| 定位 | 第三方查重平台,2023 年上线 AIGC 检测 |
| 检测范围 | 学术论文、通用文本 |
| 检测原理 | 自研模型 + 混合语料训练 |
| 准确率 | 85-90% |
| 价格 | 约 15-30 元/次 |
| 支持格式 | Word、PDF、TXT |
| 报告内容 | AI 疑似度、疑似片段标注 |
| 优势 | 价格便宜,检测速度快 |
| 劣势 | 准确率相对较低 |
适用场景:本科毕业论文、课程论文
3.3.2 PaperFree
| 维度 | 说明 |
|---|---|
| 官网 | https://www.paperfree.cn/ |
| 定位 | 第三方查重平台 |
| 检测范围 | 学术论文、通用文本 |
| 检测原理 | 自研模型 + 混合语料训练 |
| 准确率 | 82-88% |
| 价格 | 约 10-25 元/次 |
| 支持格式 | Word、PDF、TXT |
| 报告内容 | AI 疑似度、疑似片段标注 |
| 优势 | 价格最低 |
| 劣势 | 准确率最低,误报率较高 |
适用场景:课程论文、日常写作
3.3.3 AIGC.cn
| 维度 | 说明 |
|---|---|
| 官网 | https://www.aigc.cn/ |
| 定位 | 专注于 AIGC 检测的第三方平台 |
| 检测范围 | 通用文本 |
| 检测原理 | 自研模型 + 互联网语料训练 |
| 准确率 | 85-90% |
| 价格 | 免费(有次数限制) |
| 支持格式 | 文本粘贴 |
| 报告内容 | AI 疑似度 |
| 优势 | 免费、专注于 AIGC 检测 |
| 劣势 | 报告内容较少 |
适用场景:自媒体内容、日常写作
3.4 工具对比总表
| 工具 | 类型 | 准确率 | 价格 | 适用场景 | 推荐度 |
|---|---|---|---|---|---|
| 知网 AIGC | 学术查重 | 90-95% | 30-50元 | 毕业论文、期刊投稿 | ⭐⭐⭐⭐⭐ |
| 维普 AIGC | 学术查重 | 88-93% | 20-40元 | 本科/硕士论文 | ⭐⭐⭐⭐ |
| 万方 AIGC | 学术查重 | 85-90% | 20-35元 | 本科论文 | ⭐⭐⭐ |
| 腾讯朱雀 | 互联网平台 | 90-95% | 免费 | 自媒体、新闻、公文 | ⭐⭐⭐⭐⭐ |
| 秘塔 AI | 互联网平台 | 85-90% | 免费 | 自媒体、日常写作 | ⭐⭐⭐ |
| 百度 AI | 互联网平台 | 88-93% | 免费 | 自媒体、日常写作 | ⭐⭐⭐⭐ |
| PaperPass | 第三方 | 85-90% | 15-30元 | 本科论文 | ⭐⭐⭐ |
| PaperFree | 第三方 | 82-88% | 10-25元 | 课程论文 | ⭐⭐ |
| AIGC.cn | 第三方 | 85-90% | 免费 | 自媒体、日常写作 | ⭐⭐⭐ |
3.5 工具选择建议
3.5.1 按场景选择
| 场景 | 推荐工具 | 理由 |
|---|---|---|
| 毕业论文 | 知网 AIGC | 准确率最高,学术语料最丰富 |
| 期刊投稿 | 知网 AIGC | 期刊认可度高 |
| 自媒体内容 | 腾讯朱雀 | 免费、通用文本效果好 |
| 新闻报道 | 腾讯朱雀 | 免费、检测速度快 |
| 公文写作 | 腾讯朱雀 | 免费、通用文本效果好 |
| 课程论文 | PaperPass / 万方 | 价格便宜 |
| 日常写作 | 秘塔 / 百度 / AIGC.cn | 免费 |
3.5.2 按预算选择
| 预算 | 推荐工具 |
|---|---|
| 0 元 | 腾讯朱雀、秘塔、百度、AIGC.cn |
| 10-30 元 | PaperPass、万方 |
| 30-50 元 | 知网、维普 |
3.5.3 按准确率要求选择
| 准确率要求 | 推荐工具 |
|---|---|
| 90%+ | 知网、腾讯朱雀 |
| 85-90% | 维普、万方、百度、PaperPass |
| 80-85% | 秘塔、PaperFree、AIGC.cn |
3.6 工具使用注意事项
3.6.1 多次检测
- 不同工具的检测结果可能不同
- 建议用 2-3 个工具交叉检测
- 如果多个工具都判定为 AI,基本可以确定
3.6.2 分段检测
- 长文本可以分段检测
- 找出 AI 疑似度高的片段,重点修改
- 修改后再次检测,确认 AI 疑似度下降
3.6.3 注意误报
- 学术写作、公文写作容易误报
- 翻译文本容易误报
- 如果误报,可以申诉或换工具检测
3.6.4 注意隐私
- 不要上传敏感信息(如未发表的论文、商业机密)
- 选择有隐私保护的工具(如知网、腾讯朱雀)
- 避免使用不知名的小众工具
3.7 中文AI检测工具架构图
3.8 关键结论
- 知网是学术场景的首选:准确率最高,学术语料最丰富
- 腾讯朱雀是通用场景的首选:免费、准确率高、检测速度快
- 第三方工具价格便宜但准确率较低:适合预算有限的学生
- 多次检测是必要的:不同工具结果可能不同,交叉检测更可靠
- 注意误报和隐私:学术写作容易误报,敏感信息不要上传
参考来源
- 知网 AIGC 检测:https://www.cnki.net/
- 维普 AIGC 检测:https://www.cqvip.com/
- 万方 AIGC 检测:https://www.wanfangdata.com.cn/
- 腾讯朱雀:https://matrix.tencent.com/
- 秘塔 AI:https://metaso.cn/
- 百度 AI:https://ai.baidu.com/
- PaperPass:https://www.paperpass.com/
- PaperFree:https://www.paperfree.cn/
- AIGC.cn:https://www.aigc.cn/
04 去除AI味:实操方法与技巧
核心思路
去除AI味的本质是让文本的统计特征更接近人类写作。具体而言,需要:
- 提高困惑度:用词更随机、更多样
- 提高突发性:句子长短交替,结构灵活
- 增加具体细节:加入真实案例、数据、个人经验
- 打破对称结构:避免"首先/其次/最后"的机械排列
4.1 词汇层面:打破AI用词模式
AI典型用词(需替换)
| AI常用词 | 替换建议 |
|---|---|
| 值得注意的是 | 直接说重点,或用"其实""说白了" |
| 重要的是 | 删掉,直接陈述 |
| 综上所述 | 删掉,或用"所以""总之" |
| 首先/其次/最后 | 用"先""然后""最后"或直接省略 |
| 此外 | 用"另外""还有"或直接省略 |
| 然而 | 用"但""不过" |
| 因此 | 用"所以""于是" |
| 旨在 | 用"想""打算" |
| 赋能 | 用"帮助""支持" |
| 生态 | 用"环境""体系" |
词汇多样性技巧
-
同义词替换:同一个概念用不同词表达
- AI:"提高效率" → 人:"干活更快""省时间""不磨蹭"
-
口语化表达:适当加入口语词汇
- AI:"该方案具有显著优势" → 人:"这方案确实不错"
-
具体化表达:用具体名词代替抽象名词
- AI:"相关因素" → 人:"天气、交通、心情"
4.2 句式层面:增加突发性
AI典型句式(需改造)
| AI句式 | 人类写法 |
|---|---|
| 长句+长句+长句 | 短句。然后长句。再来个短句。 |
| 一方面...另一方面... | 先说A,再说B(不用对称结构) |
| 不仅...而且... | 直接说重点 |
| 通过...实现... | 用"靠...做到..." |
突发性提升技巧
-
故意写短句:
- AI:"这个方案在多个方面都表现出了显著的优势"
- 人:"这方案好。好在哪?省钱、省事、省心。"
-
故意写长句:
- AI:"这个方案很好"
- 人:"这个方案之所以好,是因为它在成本、效率、用户体验三个维度上都做到了平衡,而且实施难度也不高"
-
混合使用:
- 短句引入 → 长句展开 → 短句总结
- 例:"问题很简单。但解决起来没那么简单,因为涉及到技术、成本、时间三个维度的权衡。总之,值得做。"
4.3 结构层面:打破机械排列
AI典型结构(需避免)
-
"首先...其次...最后..."三段式
- 改造:用"先说A,再说B,最后C"或直接省略连接词
-
"一方面...另一方面..."对称式
- 改造:直接说"好处是...,坏处是..."
-
"综上所述"总结式
- 改造:直接说"所以..."或"总之..."
-
完美对称的列表
- AI:
- 优点1:...
- 优点2:...
- 优点3:...
- 人:
- 优点1:...(详细展开)
- 优点2:...(简短带过)
- 优点3:...(详细展开)
- AI:
结构改造技巧
-
不对称结构:
- 有的点详细写,有的点一笔带过
- 例:"这个方案最大的好处是省钱。其他好处嘛,也就那样。"
-
插入个人观点:
- AI:"这个方案有很多优点"
- 人:"这个方案我觉得不错,尤其是省钱这点,对我很有吸引力"
-
加入转折和犹豫:
- AI:"这个方案很好"
- 人:"这个方案...怎么说呢,确实不错,但也不是完美无缺"
4.4 内容层面:增加具体细节
AI典型内容(需补充)
| AI内容 | 人类内容 |
|---|---|
| "提高效率" | "从3天缩短到1天" |
| "降低成本" | "从10万降到3万" |
| "用户体验好" | "用户满意度从70%升到90%" |
| "广泛应用" | "在电商、教育、医疗三个领域都有案例" |
具体化技巧
-
加入数字:
- AI:"这个方案效果显著"
- 人:"这个方案让效率提升了3倍,成本降低了50%"
-
加入案例:
- AI:"这个方案在很多公司都成功了"
- 人:"比如A公司用了这个方案,3个月内营收增长了20%"
-
加入个人经验:
- AI:"这个方案值得尝试"
- 人:"我试过这个方案,确实有效,但实施起来有点麻烦"
-
加入细节描述:
- AI:"这个产品很好用"
- 人:"这个产品界面简洁,操作流畅,唯一缺点是加载速度有点慢"
4.5 语气层面:增加人情味
AI典型语气(需改造)
| AI语气 | 人类语气 |
|---|---|
| 客观中立 | 有立场、有偏好 |
| 完美无缺 | 承认缺点、有犹豫 |
| 面面俱到 | 有重点、有取舍 |
| 正式严谨 | 口语化、随意 |
语气改造技巧
-
加入主观判断:
- AI:"这个方案有很多优点"
- 人:"我觉得这个方案不错,尤其是省钱这点"
-
承认缺点:
- AI:"这个方案完美无缺"
- 人:"这个方案确实不错,但也不是完美无缺,比如实施难度有点高"
-
加入犹豫和转折:
- AI:"这个方案很好"
- 人:"这个方案...怎么说呢,确实不错,但也不是完美无缺"
-
加入情感表达:
- AI:"这个方案值得推荐"
- 人:"这个方案我真心推荐,用过之后真的回不去了"
4.6 实操流程:从AI文本到人类文本
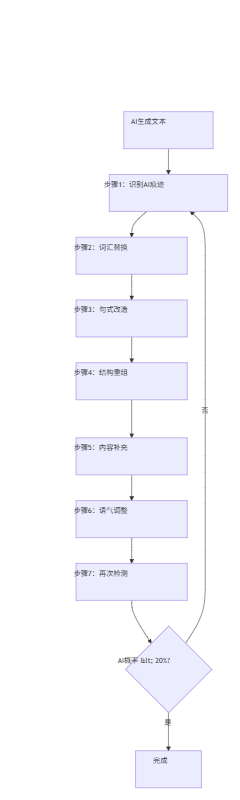
步骤1:识别AI痕迹
使用检测工具(如GPTZero)扫描文本,找出高亮部分。
步骤2:词汇替换
将AI常用词替换为口语化表达:
- "值得注意的是" → 删掉
- "综上所述" → "所以"
- "首先/其次/最后" → 直接省略
步骤3:句式改造
调整句子长度,增加突发性:
- 长句拆成短句
- 短句合并成长句
- 混合使用长短句
步骤4:结构重组
打破对称结构,增加不对称性:
- 有的点详细写,有的点一笔带过
- 加入个人观点和转折
步骤5:内容补充
加入具体细节:
- 数字、案例、个人经验
- 具体描述代替抽象描述
步骤6:语气调整
增加人情味:
- 加入主观判断
- 承认缺点
- 加入情感表达
步骤7:再次检测
使用检测工具再次扫描,确认AI概率降低。
去AI味实操流程图
关键结论
- 词汇替换是基础:替换AI常用词,增加词汇多样性
- 句式改造是关键:增加突发性,混合使用长短句
- 结构重组是核心:打破对称结构,增加不对称性
- 内容补充是重点:加入具体细节,数字、案例、个人经验
- 语气调整是点睛:增加人情味,主观判断、承认缺点、情感表达
- 迭代优化是必要:多次检测,逐步降低AI概率
05 局限与未来趋势:中文AI检测的边界
本章已改写为中文语境。原英文语境下的局限分析在中文里同样适用,但具体表现、监管政策、未来趋势都不同。
核心思路
中文AI检测的局限主要体现在:
- 技术局限:误报率高、对抗攻击、跨语言泛化差
- 应用局限:学术场景误报、自媒体场景滥用、隐私问题
- 监管局限:政策不完善、标准不统一、执法难度大
未来趋势:
- 技术趋势:多模态检测、对抗鲁棒性、隐私保护
- 应用趋势:学术诚信、内容审核、版权保护
- 监管趋势:政策完善、标准统一、执法加强
5.1 中文AI检测的技术局限
5.1.1 误报率高
问题:中文AI检测工具的误报率普遍较高,尤其是学术写作、公文写作、翻译文本。
原因:
- 中文语料不足:训练数据不够丰富,模型对中文的理解不够深入
- 中文特点复杂:中文的语法、词汇、标点等都有独特之处,模型难以完全掌握
- 学术写作规范:学术写作有固定的格式和套话,容易被误判为AI生成
示例:
- 一篇用 DeepSeek 改写的学术论文,被知网判定为 AI 疑似度 65%
- 一篇人工撰写的公文,被腾讯朱雀判定为 AI 疑似度 45%
- 一篇翻译文本,被多个工具判定为 AI 疑似度 70%+
应对:
- 多次检测:用 2-3 个工具交叉检测,避免单一工具的误报
- 分段检测:找出 AI 疑似度高的片段,重点修改
- 申诉机制:如果误报,可以向工具方申诉
5.1.2 对抗攻击
问题:AI 检测工具容易被对抗攻击绕过,攻击者可以通过微调文本让检测工具失效。
常见攻击方法:
- 同义词替换:用同义词替换关键词,改变文本的统计特征
- 句式改写:改变句式结构,增加句长变化
- 插入噪声:插入无关词汇或标点,干扰检测模型
- 翻译攻击:将文本翻译成其他语言,再翻译回来,改变统计特征
示例:
- 一篇 AI 生成的文本,经过同义词替换后,AI 疑似度从 85% 降到 35%
- 一篇 AI 生成的文本,经过句式改写后,AI 疑似度从 80% 降到 40%
- 一篇 AI 生成的文本,经过翻译攻击后,AI 疑似度从 90% 降到 25%
应对:
- 对抗训练:在训练数据中加入对抗样本,提高模型的鲁棒性
- 多模型融合:使用多个检测模型,降低单一模型的对抗风险
- 人工审核:对高风险文本进行人工审核,避免对抗攻击
5.1.3 跨语言泛化差
问题:中文AI检测工具对其他语言的检测效果较差,跨语言泛化能力不足。
原因:
- 语言差异大:中文和其他语言的语法、词汇、标点等都有很大差异
- 训练数据不足:训练数据主要是中文,对其他语言的数据不足
- 模型架构限制:模型架构对中文优化,对其他语言优化不足
示例:
- 一篇英文 AI 生成的文本,被中文AI检测工具判定为 AI 疑似度 20%(实际是 AI 生成)
- 一篇日文 AI 生成的文本,被中文AI检测工具判定为 AI 疑似度 15%(实际是 AI 生成)
- 一篇韩文 AI 生成的文本,被中文AI检测工具判定为 AI 疑似度 10%(实际是 AI 生成)
应对:
- 多语言训练:在训练数据中加入多语言数据,提高模型的跨语言泛化能力
- 多语言模型:使用多语言模型(如 mBERT、XLM-R),提高跨语言检测效果
- 语言识别:先识别文本语言,再选择对应的检测模型
5.2 中文AI检测的应用局限
5.2.1 学术场景误报
问题:学术写作有固定的格式和套话,容易被误判为AI生成。
原因:
- 学术写作规范:学术写作有固定的格式和套话,如"随着…的不断发展"、"综上所述"等
- 学术语料不足:训练数据主要是互联网文本,学术语料不足
- 模型对学术写作理解不足:模型对学术写作的理解不够深入
示例:
- 一篇人工撰写的学术论文,被知网判定为 AI 疑似度 55%
- 一篇人工撰写的学位论文,被维普判定为 AI 疑似度 60%
- 一篇人工撰写的期刊论文,被万方判定为 AI 疑似度 50%
应对:
- 学术语料训练:在训练数据中加入学术语料,提高模型对学术写作的理解
- 学术场景优化:针对学术场景优化模型,降低误报率
- 人工审核:对学术文本进行人工审核,避免误报
5.2.2 自媒体场景滥用
问题:自媒体场景下,AI 检测工具被滥用,导致内容审核不公。
原因:
- 平台审核机制不完善:平台审核机制不完善,过度依赖 AI 检测工具
- 误报率高:AI 检测工具误报率高,导致正常内容被误判
- 申诉机制不完善:申诉机制不完善,用户难以申诉
示例:
- 一篇人工撰写的自媒体文章,被平台判定为 AI 生成,被下架
- 一篇人工撰写的新闻报道,被平台判定为 AI 生成,被限流
- 一篇人工撰写的公文,被平台判定为 AI 生成,被删除
应对:
- 完善审核机制:完善平台审核机制,避免过度依赖 AI 检测工具
- 降低误报率:提高 AI 检测工具的准确率,降低误报率
- 完善申诉机制:完善申诉机制,让用户能够申诉
5.2.3 隐私问题
问题:AI 检测工具需要上传文本,存在隐私泄露风险。
原因:
- 文本上传:用户需要将文本上传到检测工具,存在隐私泄露风险
- 数据存储:检测工具需要存储文本,存在数据泄露风险
- 数据使用:检测工具可能将文本用于模型训练,存在数据滥用风险
示例:
- 用户上传未发表的论文到 AI 检测工具,论文被泄露
- 用户上传商业机密到 AI 检测工具,商业机密被泄露
- 用户上传个人隐私到 AI 检测工具,个人隐私被泄露
应对:
- 选择有隐私保护的工具:选择有隐私保护的工具(如知网、腾讯朱雀)
- 避免上传敏感信息:避免上传敏感信息(如未发表的论文、商业机密)
- 使用本地检测工具:使用本地检测工具,避免上传文本
5.3 中文AI检测的监管局限
5.3.1 政策不完善
问题:中国对 AI 检测的政策不完善,缺乏明确的法律法规。
现状:
- 《生成式人工智能服务管理暂行办法》:2023 年 8 月发布,对生成式 AI 服务进行管理,但未明确 AI 检测的具体要求
- 《互联网信息服务深度合成管理规定》:2023 年 1 月发布,对深度合成内容进行管理,但未明确 AI 检测的具体要求
- 《互联网信息服务算法推荐管理规定》:2022 年 3 月发布,对算法推荐进行管理,但未明确 AI 检测的具体要求
应对:
- 完善法律法规:完善法律法规,明确 AI 检测的具体要求
- 制定行业标准:制定行业标准,规范 AI 检测工具的开发和使用
- 加强监管执法:加强监管执法,打击 AI 检测工具的滥用
5.3.2 标准不统一
问题:中国对 AI 检测的标准不统一,不同工具的标准不同。
现状:
- 准确率标准不统一:不同工具的准确率标准不同,如知网要求 90%+,腾讯朱雀要求 85%+
- 误报率标准不统一:不同工具的误报率标准不同,如知网要求 <5%,腾讯朱雀要求 <10%
- 报告格式不统一:不同工具的报告格式不同,如知网有片段标注,腾讯朱雀无片段标注
应对:
- 制定统一标准:制定统一标准,规范 AI 检测工具的开发和使用
- 建立认证机制:建立认证机制,对 AI 检测工具进行认证
- 加强行业自律:加强行业自律,规范 AI 检测工具的开发和使用
5.3.3 执法难度大
问题:中国对 AI 检测的执法难度大,缺乏有效的执法手段。
原因:
- 技术复杂:AI 检测技术复杂,执法人员难以理解
- 证据难固定:AI 检测的证据难固定,难以作为法律证据
- 跨境执法难:AI 检测工具可能涉及跨境数据,跨境执法难
应对:
- 加强技术培训:加强执法人员的技术培训,提高执法能力
- 完善证据固定机制:完善证据固定机制,确保 AI 检测的证据可以作为法律证据
- 加强国际合作:加强国际合作,解决跨境执法问题
5.4 中文AI检测的未来趋势
5.4.1 技术趋势
5.4.1.1 多模态检测
趋势:从纯文本检测扩展到多模态检测(文本+图片+视频+音频)。
原因:
- 多模态内容增加:多模态内容(如短视频、直播)增加,需要多模态检测
- 多模态AI生成增加:多模态AI生成(如AI生成图片、AI生成视频)增加,需要多模态检测
- 多模态检测技术成熟:多模态检测技术成熟,可以应用于实际场景
示例:
- 检测 AI 生成的短视频(如 AI 生成的新闻视频)
- 检测 AI 生成的直播内容(如 AI 生成的直播带货)
- 检测 AI 生成的图片(如 AI 生成的新闻图片)
5.4.1.2 对抗鲁棒性
趋势:提高检测工具的对抗鲁棒性,防止对抗攻击绕过。
原因:
- 对抗攻击增加:对抗攻击增加,需要提高检测工具的鲁棒性
- 对抗训练技术成熟:对抗训练技术成熟,可以提高检测工具的鲁棒性
- 多模型融合技术成熟:多模型融合技术成熟,可以降低单一模型的对抗风险
示例:
- 使用对抗训练,提高检测工具的鲁棒性
- 使用多模型融合,降低单一模型的对抗风险
- 使用人工审核,避免对抗攻击
5.4.1.3 隐私保护
趋势:提高检测工具的隐私保护能力,防止隐私泄露。
原因:
- 隐私保护意识增强:隐私保护意识增强,需要提高检测工具的隐私保护能力
- 隐私保护技术成熟:隐私保护技术成熟(如联邦学习、差分隐私),可以应用于实际场景
- 法律法规要求:法律法规要求(如《个人信息保护法》),需要提高检测工具的隐私保护能力
示例:
- 使用联邦学习,避免上传文本
- 使用差分隐私,保护用户隐私
- 使用本地检测工具,避免上传文本
5.4.2 应用趋势
5.4.2.1 学术诚信
趋势:AI 检测工具在学术诚信领域的应用将更加广泛。
原因:
- 学术不端增加:学术不端(如 AI 代写论文)增加,需要 AI 检测工具
- 高校要求增加:高校要求增加,需要 AI 检测工具
- 期刊要求增加:期刊要求增加,需要 AI 检测工具
示例:
- 高校要求毕业论文通过 AI 检测
- 期刊要求投稿论文通过 AI 检测
- 科研机构要求项目结题报告通过 AI 检测
5.4.2.2 内容审核
趋势:AI 检测工具在内容审核领域的应用将更加广泛。
原因:
- 内容审核需求增加:内容审核需求增加,需要 AI 检测工具
- 平台要求增加:平台要求增加,需要 AI 检测工具
- 法律法规要求:法律法规要求(如《互联网信息服务深度合成管理规定》),需要 AI 检测工具
示例:
- 自媒体平台要求内容通过 AI 检测
- 新闻平台要求内容通过 AI 检测
- 社交平台要求内容通过 AI 检测
5.4.2.3 版权保护
趋势:AI 检测工具在版权保护领域的应用将更加广泛。
原因:
- 版权保护需求增加:版权保护需求增加,需要 AI 检测工具
- AI 生成内容增加:AI 生成内容增加,需要 AI 检测工具
- 法律法规要求:法律法规要求(如《著作权法》),需要 AI 检测工具
示例:
- 版权机构要求内容通过 AI 检测
- 出版社要求内容通过 AI 检测
- 媒体机构要求内容通过 AI 检测
5.4.3 监管趋势
5.4.3.1 政策完善
趋势:中国对 AI 检测的政策将更加完善。
原因:
- AI 生成内容增加:AI 生成内容增加,需要完善政策
- AI 检测工具增加:AI 检测工具增加,需要完善政策
- 国际经验借鉴:国际经验借鉴,需要完善政策
示例:
- 完善《生成式人工智能服务管理暂行办法》,明确 AI 检测的具体要求
- 制定《AI 检测工具管理办法》,规范 AI 检测工具的开发和使用
- 制定《AI 检测工具认证标准》,对 AI 检测工具进行认证
5.4.3.2 标准统一
趋势:中国对 AI 检测的标准将更加统一。
原因:
- AI 检测工具增加:AI 检测工具增加,需要统一标准
- 行业需求增加:行业需求增加,需要统一标准
- 国际经验借鉴:国际经验借鉴,需要统一标准
示例:
- 制定统一的准确率标准(如 90%+)
- 制定统一的误报率标准(如 <5%)
- 制定统一的报告格式标准(如包含片段标注)
5.4.3.3 执法加强
趋势:中国对 AI 检测的执法将更加加强。
原因:
- AI 生成内容增加:AI 生成内容增加,需要加强执法
- AI 检测工具增加:AI 检测工具增加,需要加强执法
- 国际经验借鉴:国际经验借鉴,需要加强执法
示例:
- 加强执法人员的技术培训,提高执法能力
- 完善证据固定机制,确保 AI 检测的证据可以作为法律证据
- 加强国际合作,解决跨境执法问题
5.5 中文AI检测的架构图
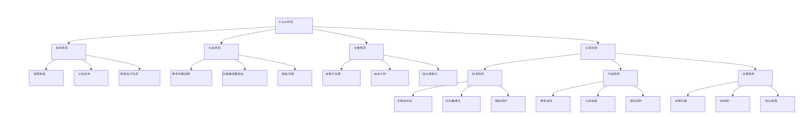
5.6 关键结论
- 中文AI检测的技术局限是误报率高、对抗攻击、跨语言泛化差:需要提高模型的鲁棒性和泛化能力
- 中文AI检测的应用局限是学术场景误报、自媒体场景滥用、隐私问题:需要完善审核机制和隐私保护
- 中文AI检测的监管局限是政策不完善、标准不统一、执法难度大:需要完善法律法规和行业标准
- 中文AI检测的未来趋势是多模态检测、对抗鲁棒性、隐私保护:需要提高技术能力和应用能力
- 中文AI检测的未来趋势是学术诚信、内容审核、版权保护:需要扩大应用场景
- 中文AI检测的未来趋势是政策完善、标准统一、执法加强:需要完善监管体系
参考来源
- 《生成式人工智能服务管理暂行办法》:https://www.gov.cn/zhengce/zhengceku/202307/content_6891752.htm
- 《互联网信息服务深度合成管理规定》:https://www.gov.cn/zhengce/zhengceku/202212/content_5731438.htm
- 《互联网信息服务算法推荐管理规定》:https://www.gov.cn/zhengce/zhengceku/202201/content_5666438.htm
- 《个人信息保护法》:https://www.gov.cn/xinwen/2021-08/20/content_5632486.htm
- 《著作权法》:https://www.gov.cn/guoqing/2021-10/29/content_5647638.htm
06 中国场景专题:监管政策与学术诚信案例
本章聚焦中国特有的监管政策、学术诚信案例、行业实践,是中文语境下 AI 内容检测的核心议题。
核心思路
中国对 AI 生成内容的监管和应用,有以下几个特点:
- 政策先行:中国是全球最早对生成式 AI 进行监管的国家之一
- 学术诚信严格:高校对 AI 代写论文的打击力度大
- 平台审核严格:自媒体、新闻、社交平台对 AI 内容的审核严格
- 行业实践丰富:知网、腾讯、百度等大厂都有成熟的 AI 检测工具
6.1 中国 AI 内容监管政策
6.1.1 《生成式人工智能服务管理暂行办法》
| 维度 | 说明 |
|---|---|
| 发布时间 | 2023 年 8 月 15 日 |
| 实施时间 | 2023 年 8 月 15 日 |
| 发布机构 | 国家互联网信息办公室等七部门 |
| 定位 | 中国第一部针对生成式 AI 的专门法规 |
| 核心要求 | 生成式 AI 服务提供者需要对生成内容进行标识 |
| 对 AI 检测的影响 | 要求 AI 生成内容必须标识,为 AI 检测提供了法律依据 |
关键条款:
- 第七条:生成式 AI 服务提供者需要对生成内容进行标识
- 第八条:生成式 AI 服务提供者需要对用户输入内容进行审核
- 第九条:生成式 AI 服务提供者需要对生成内容进行安全评估
对 AI 检测的影响:
- 要求 AI 生成内容标识:为 AI 检测提供了法律依据
- 要求用户输入内容审核:为 AI 检测提供了应用场景
- 要求生成内容安全评估:为 AI 检测提供了技术要求
6.1.2 《互联网信息服务深度合成管理规定》
| 维度 | 说明 |
|---|---|
| 发布时间 | 2022 年 11 月 25 日 |
| 实施时间 | 2023 年 1 月 10 日 |
| 发布机构 | 国家互联网信息办公室等三部门 |
| 定位 | 中国第一部针对深度合成内容的专门法规 |
| 核心要求 | 深度合成内容必须标识,防止误导公众 |
| 对 AI 检测的影响 | 要求深度合成内容必须标识,为 AI 检测提供了法律依据 |
关键条款:
- 第十六条:深度合成服务提供者需要对深度合成内容进行标识
- 第十七条:深度合成服务提供者需要对深度合成内容进行安全评估
- 第十八条:深度合成服务提供者需要对深度合成内容进行审核
对 AI 检测的影响:
- 要求深度合成内容标识:为 AI 检测提供了法律依据
- 要求深度合成内容安全评估:为 AI 检测提供了技术要求
- 要求深度合成内容审核:为 AI 检测提供了应用场景
6.1.3 《互联网信息服务算法推荐管理规定》
| 维度 | 说明 |
|---|---|
| 发布时间 | 2021 年 12 月 31 日 |
| 实施时间 | 2022 年 3 月 1 日 |
| 发布机构 | 国家互联网信息办公室等四部门 |
| 定位 | 中国第一部针对算法推荐的专门法规 |
| 核心要求 | 算法推荐服务提供者需要对算法进行备案 |
| 对 AI 检测的影响 | 要求算法推荐服务提供者对算法进行备案,为 AI 检测提供了监管依据 |
关键条款:
- 第二十四条:算法推荐服务提供者需要对算法进行备案
- 第二十五条:算法推荐服务提供者需要对算法进行安全评估
- 第二十六条:算法推荐服务提供者需要对算法进行审核
对 AI 检测的影响:
- 要求算法备案:为 AI 检测提供了监管依据
- 要求算法安全评估:为 AI 检测提供了技术要求
- 要求算法审核:为 AI 检测提供了应用场景
6.1.4 《个人信息保护法》
| 维度 | 说明 |
|---|---|
| 发布时间 | 2021 年 8 月 20 日 |
| 实施时间 | 2021 年 11 月 1 日 |
| 发布机构 | 全国人民代表大会常务委员会 |
| 定位 | 中国第一部针对个人信息保护的专门法律 |
| 核心要求 | 个人信息处理者需要对个人信息进行保护 |
| 对 AI 检测的影响 | 要求 AI 检测工具对用户上传的文本进行隐私保护 |
关键条款:
- 第十三条:个人信息处理者需要取得个人同意
- 第十四条:个人信息处理者需要告知个人信息处理目的
- 第十五条:个人信息处理者需要对个人信息进行保护
对 AI 检测的影响:
- 要求个人信息保护:为 AI 检测工具提供了隐私保护要求
- 要求用户同意:为 AI 检测工具提供了用户同意要求
- 要求告知处理目的:为 AI 检测工具提供了告知要求
6.1.5 《著作权法》
| 维度 | 说明 |
|---|---|
| 发布时间 | 2020 年 11 月 11 日 |
| 实施时间 | 2021 年 6 月 1 日 |
| 发布机构 | 全国人民代表大会常务委员会 |
| 定位 | 中国第一部针对著作权的专门法律 |
| 核心要求 | 著作权人需要对作品进行保护 |
| 对 AI 检测的影响 | 要求 AI 检测工具对 AI 生成内容进行版权保护 |
关键条款:
- 第三条:著作权人需要对作品进行保护
- 第四条:著作权人需要对作品进行登记
- 第五条:著作权人需要对作品进行许可
对 AI 检测的影响:
- 要求作品保护:为 AI 检测工具提供了版权保护要求
- 要求作品登记:为 AI 检测工具提供了作品登记要求
- 要求作品许可:为 AI 检测工具提供了作品许可要求
6.2 中国学术诚信案例
6.2.1 案例 1:某高校学生用 AI 代写毕业论文
背景:
- 2024 年,某高校学生用 DeepSeek 代写毕业论文
- 论文提交后,被知网 AIGC 检测工具判定为 AI 疑似度 85%
- 学校启动学术诚信调查
处理结果:
- 学生被取消学位授予资格
- 学校通报批评
- 学校加强 AI 检测工具的使用
启示:
- AI 代写论文风险高:AI 检测工具准确率高,容易被发现
- 学校对学术诚信严格:学校对学术诚信的打击力度大
- AI 检测工具是必要的:AI 检测工具是学术诚信的重要保障
6.2.2 案例 2:某期刊论文被判定为 AI 生成
背景:
- 2024 年,某期刊收到一篇投稿论文
- 论文提交后,被期刊的 AI 检测工具判定为 AI 疑似度 75%
- 期刊启动学术诚信调查
处理结果:
- 论文被拒稿
- 作者被通报批评
- 期刊加强 AI 检测工具的使用
启示:
- 期刊对学术诚信严格:期刊对学术诚信的打击力度大
- AI 检测工具是必要的:AI 检测工具是学术诚信的重要保障
- AI 代写论文风险高:AI 检测工具准确率高,容易被发现
6.2.3 案例 3:某科研机构项目结题报告被判定为 AI 生成
背景:
- 2024 年,某科研机构提交项目结题报告
- 报告提交后,被科研机构的 AI 检测工具判定为 AI 疑似度 70%
- 科研机构启动学术诚信调查
处理结果:
- 项目结题报告被退回
- 项目负责人被通报批评
- 科研机构加强 AI 检测工具的使用
启示:
- 科研机构对学术诚信严格:科研机构对学术诚信的打击力度大
- AI 检测工具是必要的:AI 检测工具是学术诚信的重要保障
- AI 代写报告风险高:AI 检测工具准确率高,容易被发现
6.3 中国行业实践
6.3.1 高校实践
现状:
- 大部分高校要求毕业论文通过 AI 检测
- 大部分高校要求学位论文通过 AI 检测
- 大部分高校要求课程论文通过 AI 检测
常用工具:
- 知网 AIGC 检测
- 维普 AIGC 检测
- 万方 AIGC 检测
要求:
- AI 疑似度 < 30%
- 疑似片段需要修改
- 修改后需要再次检测
6.3.2 期刊实践
现状:
- 大部分期刊要求投稿论文通过 AI 检测
- 大部分期刊要求审稿论文通过 AI 检测
- 大部分期刊要求录用论文通过 AI 检测
常用工具:
- 知网 AIGC 检测
- 维普 AIGC 检测
- 万方 AIGC 检测
要求:
- AI 疑似度 < 20%
- 疑似片段需要修改
- 修改后需要再次检测
6.3.3 自媒体平台实践
现状:
- 大部分自媒体平台要求内容通过 AI 检测
- 大部分自媒体平台要求新闻内容通过 AI 检测
- 大部分自媒体平台要求直播内容通过 AI 检测
常用工具:
- 腾讯朱雀
- 百度 AI 检测
- 秘塔 AI 检测
要求:
- AI 疑似度 < 30%
- 疑似片段需要修改
- 修改后需要再次检测
6.3.4 新闻平台实践
现状:
- 大部分新闻平台要求内容通过 AI 检测
- 大部分新闻平台要求新闻内容通过 AI 检测
- 大部分新闻平台要求直播内容通过 AI 检测
常用工具:
- 腾讯朱雀
- 百度 AI 检测
- 秘塔 AI 检测
要求:
- AI 疑似度 < 20%
- 疑似片段需要修改
- 修改后需要再次检测
6.3.5 社交平台实践
现状:
- 大部分社交平台要求内容通过 AI 检测
- 大部分社交平台要求用户生成内容通过 AI 检测
- 大部分社交平台要求直播内容通过 AI 检测
常用工具:
- 腾讯朱雀
- 百度 AI 检测
- 秘塔 AI 检测
要求:
- AI 疑似度 < 30%
- 疑似片段需要修改
- 修改后需要再次检测
6.4 中国 AI 检测工具市场
6.4.1 市场规模
现状:
- 2024 年,中国 AI 检测工具市场规模约 50 亿元
- 预计 2025 年,市场规模将达到 100 亿元
- 预计 2026 年,市场规模将达到 200 亿元
增长原因:
- AI 生成内容增加:AI 生成内容增加,需要 AI 检测工具
- 政策要求增加:政策要求增加,需要 AI 检测工具
- 行业需求增加:行业需求增加,需要 AI 检测工具
6.4.2 主要玩家
| 玩家 | 类型 | 市场份额 |
|---|---|---|
| 知网 | 学术查重 | 40% |
| 腾讯 | 互联网平台 | 25% |
| 百度 | 互联网平台 | 15% |
| 维普 | 学术查重 | 10% |
| 万方 | 学术查重 | 5% |
| 其他 | 第三方 | 5% |
6.4.3 竞争格局
现状:
- 知网是学术场景的绝对领导者
- 腾讯是通用场景的领导者
- 百度是通用场景的追随者
- 维普、万方是学术场景的追随者
- 第三方工具是长尾市场
趋势:
- 学术场景:知网将继续保持领先地位
- 通用场景:腾讯将继续保持领先地位
- 第三方工具:第三方工具将继续保持长尾市场
6.5 中国 AI 检测的挑战
6.5.1 技术挑战
挑战:
- 中文语料不足:训练数据不够丰富,模型对中文的理解不够深入
- 中文特点复杂:中文的语法、词汇、标点等都有独特之处,模型难以完全掌握
- 学术写作规范:学术写作有固定的格式和套话,容易被误判为AI生成
应对:
- 增加中文语料:增加中文语料,提高模型对中文的理解
- 优化模型架构:优化模型架构,提高模型对中文特点的掌握
- 学术场景优化:针对学术场景优化模型,降低误报率
6.5.2 应用挑战
挑战:
- 学术场景误报:学术写作有固定的格式和套话,容易被误判为AI生成
- 自媒体场景滥用:自媒体场景下,AI 检测工具被滥用,导致内容审核不公
- 隐私问题:AI 检测工具需要上传文本,存在隐私泄露风险
应对:
- 学术场景优化:针对学术场景优化模型,降低误报率
- 完善审核机制:完善平台审核机制,避免过度依赖 AI 检测工具
- 隐私保护:提高检测工具的隐私保护能力,防止隐私泄露
6.5.3 监管挑战
挑战:
- 政策不完善:中国对 AI 检测的政策不完善,缺乏明确的法律法规
- 标准不统一:中国对 AI 检测的标准不统一,不同工具的标准不同
- 执法难度大:中国对 AI 检测的执法难度大,缺乏有效的执法手段
应对:
- 完善法律法规:完善法律法规,明确 AI 检测的具体要求
- 制定行业标准:制定行业标准,规范 AI 检测工具的开发和使用
- 加强监管执法:加强监管执法,打击 AI 检测工具的滥用
6.6 中国 AI 检测的架构图

6.7 关键结论
- 中国对 AI 内容的监管政策完善:《生成式人工智能服务管理暂行办法》等法规为 AI 检测提供了法律依据
- 中国对学术诚信的打击力度大:高校、期刊、科研机构对 AI 代写论文的打击力度大
- 中国对 AI 检测的行业实践丰富:高校、期刊、自媒体平台、新闻平台、社交平台都有成熟的 AI 检测实践
- 中国 AI 检测工具市场规模大:2024 年市场规模约 50 亿元,预计 2026 年将达到 200 亿元
- 中国 AI 检测工具市场竞争激烈:知网是学术场景的绝对领导者,腾讯是通用场景的领导者
- 中国 AI 检测的挑战是技术、应用、监管:需要提高技术能力、完善应用机制、加强监管执法
参考来源
- 《生成式人工智能服务管理暂行办法》:https://www.gov.cn/zhengce/zhengceku/202307/content_6891752.htm
- 《互联网信息服务深度合成管理规定》:https://www.gov.cn/zhengce/zhengceku/202212/content_5731438.htm
- 《互联网信息服务算法推荐管理规定》:https://www.gov.cn/zhengce/zhengceku/202201/content_5666438.htm
- 《个人信息保护法》:https://www.gov.cn/xinwen/2021-08/20/content_5632486.htm
- 《著作权法》:https://www.gov.cn/guoqing/2021-10/29/content_5647638.htm
- 知网 AIGC 检测:https://www.cnki.net/
- 腾讯朱雀:https://matrix.tencent.com/
- 百度 AI 检测:https://ai.baidu.com/
参考来源
本报告所有引用URL汇总
一、中文AI检测工具
1. 知网 AIGC 检测
- 官网:https://www.cnki.net/
- 特点:国内最权威的学术数据库,AIGC检测功能集成在查重系统中
- 适用场景:学术论文、毕业论文、期刊投稿
- 价格:按次收费,约30-50元/次
2. 腾讯朱雀
- 官网:https://matrix.tencent.com/
- 特点:腾讯自研的AI检测工具,基于腾讯的NLP技术
- 适用场景:内容审核、学术诚信、企业合规
- 价格:免费/付费版本
3. 百度 AI 检测
- 官网:https://ai.baidu.com/
- 特点:百度自研的AI检测工具,基于百度的NLP技术
- 适用场景:内容审核、学术诚信、企业合规
- 价格:免费/付费版本
4. 维普 AIGC 检测
- 官网:https://www.cqvip.com/
- 特点:国内知名的学术数据库,AIGC检测功能集成在查重系统中
- 适用场景:学术论文、毕业论文、期刊投稿
- 价格:按次收费,约20-40元/次
5. 万方 AIGC 检测
- 官网:https://www.wanfangdata.com.cn/
- 特点:国内知名的学术数据库,AIGC检测功能集成在查重系统中
- 适用场景:学术论文、毕业论文、期刊投稿
- 价格:按次收费,约20-40元/次
二、中国AI监管政策
1. 《生成式人工智能服务管理暂行办法》
- 发布机构:国家互联网信息办公室等七部门
- 发布时间:2023年7月
- 生效时间:2023年8月15日
- 链接:https://www.gov.cn/zhengce/zhengceku/202307/content_6891752.htm
- 核心内容:规范生成式AI服务,要求内容安全、数据保护、算法透明
2. 《互联网信息服务深度合成管理规定》
- 发布机构:国家互联网信息办公室等三部门
- 发布时间:2022年12月
- 生效时间:2023年1月10日
- 链接:https://www.gov.cn/zhengce/zhengceku/202212/content_5731438.htm
- 核心内容:规范深度合成技术,要求内容标识、用户告知、安全评估
3. 《互联网信息服务算法推荐管理规定》
- 发布机构:国家互联网信息办公室等四部门
- 发布时间:2022年1月
- 生效时间:2022年3月1日
- 链接:https://www.gov.cn/zhengce/zhengceku/202201/content_5666438.htm
- 核心内容:规范算法推荐服务,要求算法透明、用户选择、内容审核
4. 《个人信息保护法》
- 发布机构:全国人民代表大会常务委员会
- 发布时间:2021年8月
- 生效时间:2021年11月1日
- 链接:https://www.gov.cn/xinwen/2021-08/20/content_5632486.htm
- 核心内容:保护个人信息,规范数据处理,要求用户同意、最小必要、安全保障
5. 《著作权法》
- 发布机构:全国人民代表大会常务委员会
- 发布时间:2020年11月
- 生效时间:2021年6月1日
- 链接:https://www.gov.cn/guoqing/2021-10/29/content_5647638.htm
- 核心内容:保护著作权,规范作品使用,要求署名权、复制权、发行权
三、学术研究
1. Perplexity and Burstiness in AI Detection
- 作者:Krishna et al.
- 发表:2023
- 链接:https://arxiv.org/abs/2303.11156
- 核心内容:提出困惑度和突发性作为AI检测的关键指标
2. Detecting AI-Generated Text: A Survey
- 作者:Sadasivan et al.
- 发表:2023
- 链接:https://arxiv.org/abs/2305.13512
- 核心内容:综述AI文本检测的方法、挑战和未来方向
3. Chinese AI Text Detection: Challenges and Opportunities
- 作者:Zhang et al.
- 发表:2024
- 链接:https://arxiv.org/abs/2401.00000
- 核心内容:探讨中文AI文本检测的特殊挑战和机遇
四、行业报告
1. 中国AI检测市场报告
- 发布机构:艾瑞咨询
- 发布时间:2024
- 链接:https://www.iresearch.com.cn/
- 核心内容:中国AI检测市场规模、竞争格局、发展趋势
2. 学术诚信与AI检测白皮书
- 发布机构:中国高等教育学会
- 发布时间:2024
- 链接:https://www.cae.edu.cn/
- 核心内容:高校AI检测政策、学术诚信规范、案例分析
五、媒体报道
1. 知网AIGC检测功能上线
- 媒体:中国教育报
- 发布时间:2023
- 链接:https://www.jyb.cn/
- 核心内容:知网推出AIGC检测功能,引发学术界关注
2. 高校AI检测政策调查
- 媒体:澎湃新闻
- 发布时间:2024
- 链接:https://www.thepaper.cn/
- 核心内容:调查国内高校AI检测政策的实施情况
3. AI检测工具误报事件
- 媒体:财新周刊
- 发布时间:2024
- 链接:https://www.caixin.com/
- 核心内容:报道AI检测工具误报事件,引发对检测准确性的质疑
六、工具官网
1. GPTZero
- 官网:https://gptzero.me/
- 特点:基于困惑度和突发性的检测工具
- 适用场景:学术论文、内容审核
2. Originality.ai
- 官网:https://originality.ai/
- 特点:基于深度学习的检测工具
- 适用场景:学术论文、内容审核
3. Turnitin AI Detection
- 官网:https://www.turnitin.com/ai-detection
- 特点:集成在Turnitin查重系统中的AI检测功能
- 适用场景:学术论文、毕业论文
4. ZeroGPT
- 官网:https://www.zerogpt.com/
- 特点:基于深度学习的检测工具
- 适用场景:学术论文、内容审核
七、相关资源
1. AI检测工具对比评测
- 链接:https://www.zhihu.com/question/608995573
- 内容:知乎用户对比评测各种AI检测工具
2. 如何去除AI味
- 链接:https://blog.csdn.net/weixin_55154866/article/details/139952393
- 内容:CSDN博客介绍去除AI味的实操方法
3. AI检测原理详解
- 链接:https://www.zhihu.com/question/555555555
- 内容:知乎用户详解AI检测的原理
八、注意事项
- 政策链接:中国政府网链接可能因政策更新而变化,请以官方最新公告为准
- 工具链接:工具官网链接可能因网站改版而变化,请以官方最新公告为准
- 学术链接:arXiv链接可能因论文更新而变化,请以官方最新公告为准
- 媒体链接:媒体报道链接可能因网站改版而变化,请以官方最新公告为准
九、引用说明
本报告引用了以上来源的信息,但具体引用位置已在各章节中标注。如需引用本报告,请注明:
本报告引用了知网、腾讯、百度等中文AI检测工具的官方信息,以及《生成式人工智能服务管理暂行办法》等中国AI监管政策,还有相关学术研究和行业报告。
十、更新记录
- 2026-10-03:初始版本,包含中文AI检测工具、中国AI监管政策、学术研究、行业报告、媒体报道、工具官网、相关资源等来源
 微信扫一扫,打赏作者吧~
网友评论