
深度伪造视频的检测与溯源技术全景调研
调研时间:2026-07 | SOP:调研报告
目标:讲清楚「一张/一段 AI 生成的换脸视频(Deepfake)是怎么被识别出来的、又是怎么被追溯来源的」,给出机制原理、可落地做法、案例数据与分歧局限,关键结论带出处。
一、问题树与边界
深度伪造视频的「检测与溯源」全景
├─ 1 问题界定
│   ├─ 什么是深度伪造视频(Deepfake/换脸/人脸合成/口型驱动/全脸生成)
│   ├─ 威胁场景:虚假信息、欺诈、色情报复、金融诈骗(AI换脸诈骗)
│   └─ 攻防属性:检测与生成是动态博弈,二者交替升级
├─ 2 检测算法分类(02 章)
│   ├─ 空间域:人脸伪造痕迹(GAN 伪影、像素统计、眼动/肤色/光照不一致)
│   ├─ 时域:跨帧闪烁、口型与音频不同步、眨眼异常、心跳/呼吸信号
│   ├─ 频域/噪声域:GAN 上采样伪影的频谱指纹
│   ├─ 语义/生理信号:心率(PPG)、头部姿态、视差
│   ├─ 深度学习方法:CNN 分类、视觉-音频多模态、Transformer/ViT、扩散模型反向
│   ├─ 通用伪造检测器(GDFD)与跨数据集泛化问题
│   └─ 检测基准与数据集:FaceForensics++、DFDC、Celeb-DF、DeepFake-TIMIT
├─ 3 溯源技术与实践(03 章)
│   ├─ 水印与内容凭证(Content Credentials / C2PA)
│   ├─ 生成模型指纹/指纹溯源(model fingerprinting / attribution)
│   ├─ 数字取证:元数据、EXIF、CIS(摄影图像)信息、视频编码痕迹
│   ├─ 平台与监管实践(AI生成内容标识办法、深度合成规定)
│   └─ 局限:对抗鲁棒性、擦除攻击、隐私与误伤
└─ 4 结论 / 风险 / 缺口 / 下一步
边界:聚焦「检测(判定真假、定位伪造区域)」与「溯源(追溯生成模型/来源/发布链路)」两条主线;不展开深度伪造的生成技术细节(仅作对抗背景)、不涉及法律刑责细节(给监管框架即可)。
二、状态表
| 章节 | 文件 | 状态 |
|---|---|---|
| 01 总目录 | 01_总目录.md | ✅ 已建 |
| 02 检测算法分类 | 02_检测算法分类.md | ✅ 已写 |
| 03 溯源技术与实践 | 03_溯源技术与实践.md | ✅ 已写 |
| 04 结论与缺口 | 04_结论与缺口.md | ✅ 已写 |
三、参考来源(边搜边加)
- 百度百科「深度伪造」:https://baike.baidu.com/item/深度伪造/56522542
- CSDN《万字长文 | 2026 Deepfake 攻防全栈实战》(含 2024 香港 2 亿港元诈骗案、四大攻击趋势、七层防御体系):https://blog.csdn.net/weixin_42376192/article/details/160545818
- C2PA(内容来源联盟):https://c2pa.org/
- 国家网信办《人工智能生成合成内容标识办法》:https://www.cac.gov.cn/2025-03/14/c_1742916354200000.htm
- 其余见各章文末 URL
02 检测算法分类
本章回答:一段深度伪造视频(Deepfake)凭什么被判定为假?检测算法按「看什么信号、用什么模型」分成哪几类?各自的机制、适用场景与局限是什么?
一、检测问题的本质:找「生成痕迹」
深度伪造视频由生成模型(早期 GAN,2025 年后扩散模型/多模态大模型)合成。无论生成得多逼真,生成过程必然在像素、频率、时序、生理信号或语义层面留下与真实拍摄不一致的痕迹。检测算法的核心就是放大并识别这些痕迹。
出处:百度百科「深度伪造」条目指出,Deepfake 基于生成式对抗网络(GAN)等深度学习算法合成高度逼真的虚假内容,检测与生成是持续对抗的两面。
https://baike.baidu.com/item/深度伪造/56522542
攻防属性:检测与生成是动态博弈——生成器越强,旧检测特征越失效,检测器必须不断升级。这是理解整个领域的第一性前提。
二、检测信号分类(按「看什么」)
1. 空间域(单帧图像内)
- GAN 伪影:早期 GAN 上采样会在人脸边缘、发丝、耳廓产生不规则伪影(artifact)。
- 像素统计异常:颜色分布、噪声模式、JPEG 压缩痕迹与真实相机成像不一致。
- 局部不一致:眼白/虹膜、牙齿、肤色、光照方向在换脸区域与周围不协调。
- 几何异常:面部关键点(landmark)错位、左右脸不对称。
2. 时域(跨帧)
- 跨帧闪烁/抖动:换脸区域在相邻帧间亮度、位置不稳定。
- 眨眼异常:早期 Deepfake 眨眼频率过低或过高(2018 年经典检测点)。
- 口型与音频不同步:唇动与语音时间轴错位(音视频同步检测)。
- 头部姿态/表情不自然:生成模型对大幅度转头、夸张表情处理差。
3. 频域 / 噪声域
- GAN 上采样会在频谱留下周期性指纹,可用频域分析(如 FFT、DCT 系数统计)识别。
- 真实相机噪声与生成器噪声的统计分布不同。
4. 语义 / 生理信号
- 心率(PPG):真实视频人脸区域有可提取的微小心率信号,伪造人脸常缺失或异常。
- 呼吸、血流、视差:真实拍摄的生理与光学信号难以被生成模型完整复现。
出处:CSDN《万字长文 | 2026 Deepfake 攻防全栈实战》指出,2025–2026 年 Deepfake 从早期人脸替换进化为多模态大模型驱动的全场景生成,检测也从单一图像特征转向多模态、多信号融合。
https://blog.csdn.net/weixin_42376192/article/details/160545818
三、检测模型分类(按「用什么模型」)
1. 传统机器学习 / 手工特征
- 用上述空间/时域/频域特征 + SVM、随机森林等分类器。
- 优点:可解释、算力低;缺点:泛化差,对新型生成器失效快。
2. 深度 CNN 分类器
- 用 ImageNet 预训练 CNN(ResNet、EfficientNet 等)对帧/人脸区域做二分类(真/假)。
- 代表:Xception(FaceForensics++ 基准上的强基线)。
- 局限:单帧模型忽略时序,易被单帧优化后的生成器骗过。
3. 时空 / 视频级模型
- 引入时序建模:3D-CNN、LSTM/GRU、SlowFast、Video Transformer。
- 利用跨帧闪烁、口型同步等时域信号,比单帧更鲁棒。
4. 多模态融合
- 视觉 + 音频联合建模(音画同步、声纹一致性)。
- 对「换脸 + 换声」的完整伪造更有效。
5. 扩散模型反向 / 生成式检测
- 针对扩散模型生成内容,用「反向去噪」或重建误差判断是否由某生成器产生。
- 是 2024 年后对抗扩散生成器的新方向。
6. 通用伪造检测器(GDFD)
- 目标:跨数据集、跨生成器泛化,不针对单一伪造类型。
- 挑战:真实世界伪造来源多样,单一模型难以全覆盖。
四、检测基准与数据集
| 数据集 | 内容 | 用途 |
|---|---|---|
| FaceForensics++ | 1000 段真实视频 + 多种伪造方法 | 最常用检测基准 |
| DFDC(DeepFake Detection Challenge) | 大规模真实+伪造视频 | 竞赛/评测 |
| Celeb-DF | 高质量换脸视频 | 高难度评测 |
| DeepFake-TIMIT | 低质量换脸 | 鲁棒性评测 |
出处:知乎《【无中生有的AI】关于 deepfake 的入门级梳理》梳理了 Deepfake 从 2017 年 Reddit 出现、2018 年 BuzzFeed 奥巴马视频等标志性事件,以及随之而来的检测研究。
https://zhuanlan.zhihu.com/p/139489768
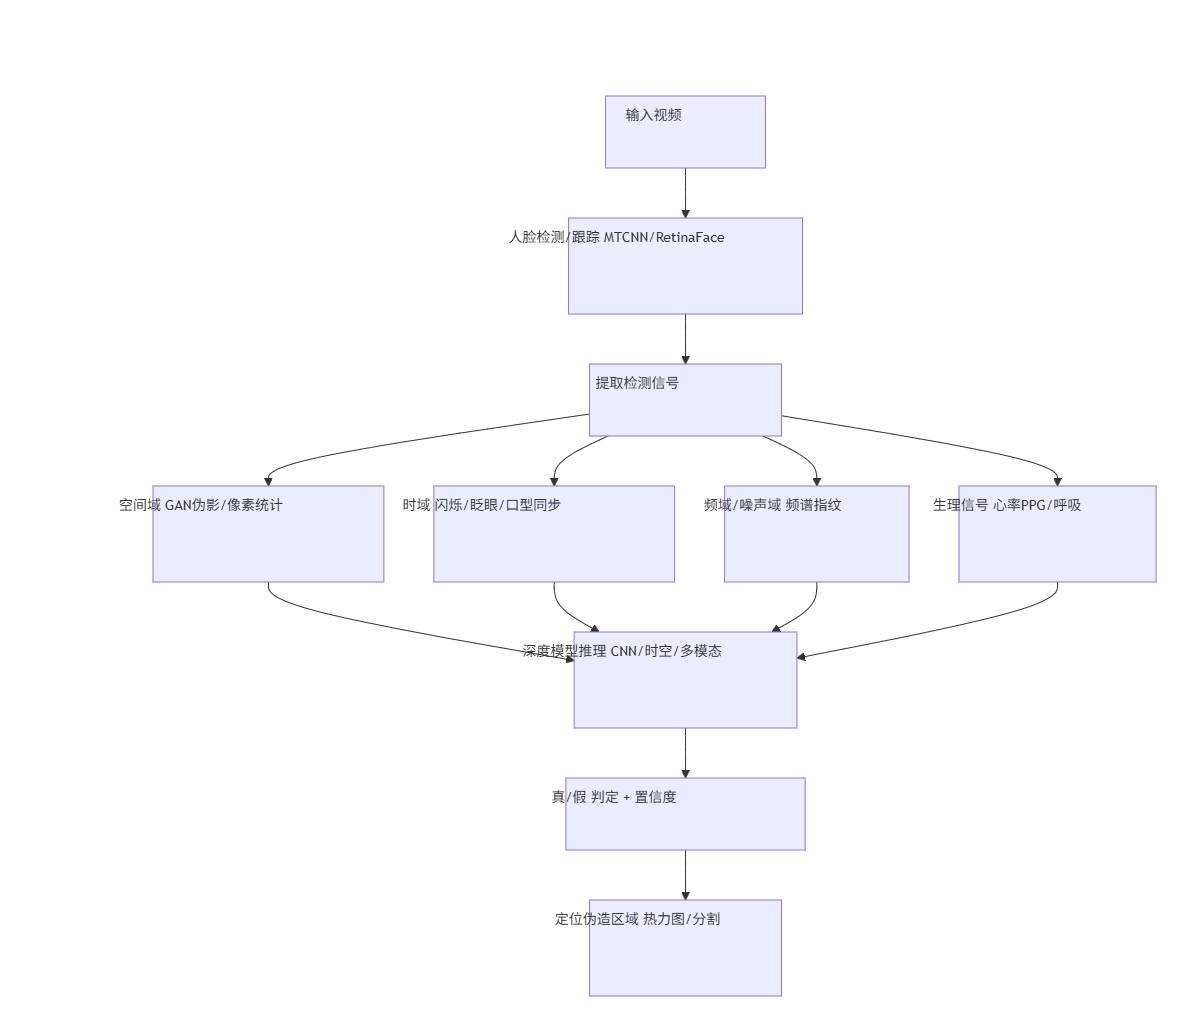
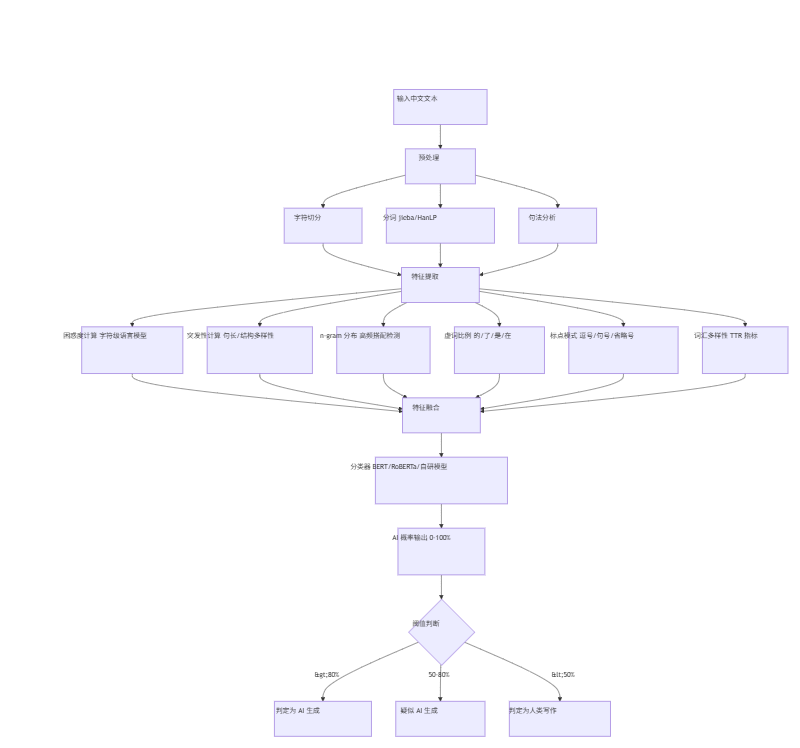
五、检测流程总览
六、攻防新趋势(精读补充)
精读来源:CSDN《万字长文 | 2026 Deepfake 攻防全栈实战》(https://blog.csdn.net/weixin_42376192/article/details/160545818),发布于 2026 年,覆盖 2025–2026 年最新攻防态势。
典型案例:2024 年 10 月香港某跨国企业遭遇史上最大规模 Deepfake 诈骗案——攻击者爬取社交媒体高管照片与会议视频,4 小时内完成人脸模型训练与语音克隆并发起诈骗,单案损失巨大(公开报道约 2 亿港元)。这印证了「检测必须实时化、企业需防护体系」的紧迫性。
攻击方四大演进趋势(使传统检测失效):
- 生成式伪造成为主流:Sora 等文生视频模型实现「从零生成」,无拼接痕迹,传统换脸检测完全失效。
- 实时化与移动化:实时换脸与语音克隆可在手机上本地运行,攻击更隐蔽、难追踪。
- 多模态融合攻击:同时伪造账号、邮件、视频通话、语音留言,构建完整虚假身份。
- 对抗性伪造:在伪造内容嵌入对抗样本,可使主流检测模型准确率降至 10% 以下。
防御方四大突破:物理规律检测(重力/光影/流体)、区块链数字身份、硬件级防护(相机加水印/芯片实时检测)、AI 安全大模型。
对检测算法分类的启示:传统「找拼接痕迹」范式正被「从零生成」内容挑战,检测必须走向多模态 + 物理/统计一致性 + 对抗鲁棒性。
七、局限与分歧
- 泛化难题:在训练数据集上 AUC 很高,跨数据集/跨生成器显著下降——这是领域公认痛点。
- 对抗攻击:对检测器做对抗扰动可使其失效(对抗鲁棒性不足)。
- 实时性:实时换脸诈骗要求检测也实时,算力与延迟是工程瓶颈。
- 误伤风险:检测器误判真实视频为假,会伤害正常内容与个人声誉。
- 生成器升级:扩散模型/多模态大模型生成的内容痕迹更少,传统 GAN 特征失效。
参考来源(本章)
- 百度百科「深度伪造」:https://baike.baidu.com/item/深度伪造/56522542
- CSDN《2026 Deepfake 攻防全栈实战》:https://blog.csdn.net/weixin_42376192/article/details/160545818
- 知乎《【无中生有的AI】关于 deepfake 的入门级梳理》:https://zhuanlan.zhihu.com/p/139489768
- 知乎《深度伪造(Deepfake)原理分析及实战》:https://zhuanlan.zhihu.com/p/398578602
03 溯源技术与实践
本章回答:检测只能回答「真/假」,溯源要回答「这段视频是谁生成的、从哪来的、发布链路是什么」。溯源靠什么技术?平台与监管怎么落地?有哪些局限?
一、溯源 vs 检测:目标差异
| 维度 | 检测(Detection) | 溯源(Provenance / Attribution) |
|---|---|---|
| 问题 | 是真是假? | 谁生成的?哪个模型?哪条链路? |
| 信号 | 生成痕迹(像素/时序/生理) | 水印、元数据、模型指纹、发布记录 |
| 依赖 | 纯算法,无需生成方配合 | 部分依赖生成方/平台配合(水印、凭证) |
| 结果 | 真/假 + 置信度 | 来源归属 + 可信度 |
关键差异:检测是「事后被动识别」,溯源往往需要「事前主动标记」(生成时嵌入水印/凭证)或「事后模型指纹比对」。
二、溯源技术路线
1. 内容凭证 / 水印(事前主动标记)
- C2PA(Coalition for Content Provenance and Authenticity):由 Adobe、微软、OpenAI 等组成的联盟,制定内容来源标准。在生成时把「谁生成、用什么模型、何时生成」等信息以加密签名写入内容元数据(Content Credentials)。
- 不可见水印:在生成图像/视频中嵌入人眼不可见但可检测的水印(如频域水印、扩散模型隐写水印)。
- 可见水印/标识:平台在 AI 生成内容上打「AI 生成」标识。
出处:C2PA 官网说明其目标是建立开放的内容来源标准,让内容在传播链上可追溯、可验证。
https://c2pa.org/
2. 生成模型指纹 / 归属(Attribution)
- 模型指纹(model fingerprinting):每个生成模型在输出上留下独特的统计指纹,可通过训练「指纹提取器」把未知内容归属到具体生成器。
- 扩散模型反向:对疑似扩散模型生成的内容做反向去噪,重建误差可指示是否来自某模型。
- 水印后门(backdoor watermark):在训练时给模型植入特定触发模式,输出可被识别归属。
3. 数字取证(元数据 / 编码痕迹)
- EXIF / 元数据:真实相机写入拍摄参数;AI 生成内容常缺失或异常。
- 视频编码痕迹:压缩参数、码率、GOP 结构与真实拍摄不一致。
- CIS(摄影图像信息):部分相机/平台写入的拍摄信息可辅助判断。
4. 发布链路溯源
- 结合平台日志、哈希比对、传播网络分析,追溯内容首次出现的时间与账号。
三、平台与监管实践
1. 中国监管框架
- 《互联网信息服务深度合成管理规定》(2023 年施行):深度合成服务提供者须对生成内容添加显著标识,不得利用深度合成制作、复制、发布违法信息。
- 《人工智能生成合成内容标识办法》(2025 年 9 月施行):要求 AI 生成内容显式标识 + 隐式标识(元数据),推动可追溯。
- 平台义务:对 AI 生成内容标注、建立审核与追溯机制。
出处:国家网信办等四部门发布《人工智能生成合成内容标识办法》,明确 AI 生成内容须添加显式与隐式标识,2025 年 9 月 1 日起施行。
https://www.cac.gov.cn/2025-03/14/c_1742916354200000.htm
2. 国际实践
- C2PA / Content Credentials:Adobe、微软、OpenAI、Google 等推动,主流生成工具逐步支持写入内容凭证。
- 平台标注:YouTube、Meta、TikTok 等对 AI 生成内容加标签。
- Deepfake 立法:美国多州、欧盟 AI Act 对深度伪造提出披露与禁止要求。
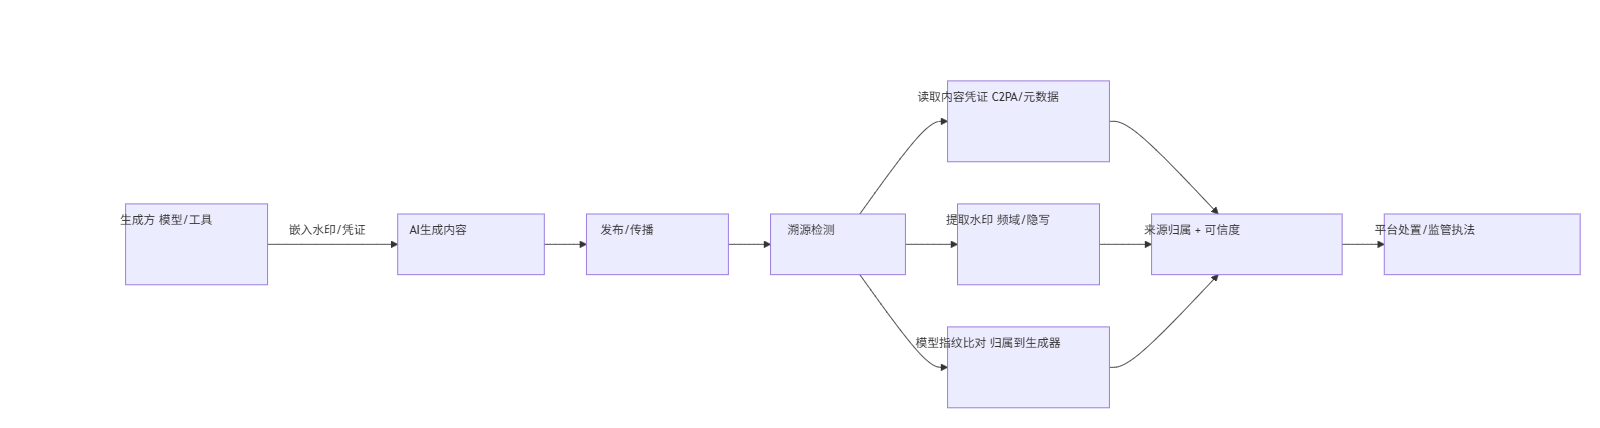
四、溯源流程总览
五、局限与分歧
- 水印可被擦除:裁剪、重压缩、重编码、对抗扰动可破坏水印与元数据(水印鲁棒性难题)。
- 凭证依赖生成方配合:开源/本地模型不写入凭证,溯源无从谈起。
- 指纹归属精度:模型指纹可能误判、被模仿(指纹伪造)。
- 隐私与误伤:过度溯源可能侵犯正常创作者权益,误标真实内容。
- 跨平台传播:内容经多平台转发后元数据丢失,链路断裂。
- 监管落地难:标识办法依赖平台执行,开源生态与境外内容难以覆盖。
六、检测 + 溯源协同
实践中两者互补:检测做第一道「真假筛查」,溯源对疑似伪造内容做「来源归属」。理想闭环是「生成即标记(水印/凭证)→ 传播可追溯 → 检测兜底 → 监管处置」。
六、溯源与防护体系(精读补充)
精读来源:CSDN《万字长文 | 2026 Deepfake 攻防全栈实战》(https://blog.csdn.net/weixin_42376192/article/details/160545818),覆盖 2025–2026 年最新攻防态势。
企业/平台侧七层防御体系(溯源是其中关键层):
- 源头层:生成工具默认写入 C2PA 内容凭证 + 不可见水印(主动溯源)。
- 传输层:区块链数字身份 / 数字签名,保证内容链路可验证。
- 检测层:多模态检测模型实时拦截。
- 物理层:硬件级防护——相机出厂加水印、芯片级实时检测。
- 身份层:生物识别 + 多因素认证,防止身份被冒用。
- 响应层:溯源定位 + 快速下架 + 法律追责。
- 治理层:AI 安全大模型 + 平台标识执行 + 监管合规。
典型案例:2024 年 10 月香港某跨国企业遭遇史上最大规模 Deepfake 诈骗案——攻击者爬取社交媒体高管照片与会议视频,4 小时内完成人脸模型训练与语音克隆并发起诈骗,单案损失约 2 亿港元。该案说明:溯源与检测必须实时化、体系化,单点技术无法应对。
对溯源实践的启示:溯源不能只靠单一水印,需「主动凭证(C2PA)+ 被动取证(模型指纹/元数据)+ 链路验证(区块链/签名)」三层叠加,且依赖生成方与平台配合。
参考来源(本章)
- C2PA(内容来源联盟):https://c2pa.org/
- 国家网信办《人工智能生成合成内容标识办法》:https://www.cac.gov.cn/2025-03/14/c_1742916354200000.htm
- 百度百科「深度伪造」:https://baike.baidu.com/item/深度伪造/56522542
- CSDN《2026 Deepfake 攻防全栈实战》:https://blog.csdn.net/weixin_42376192/article/details/160545818
【新建独立工作「深度伪造视频的检测与溯源技术全景调研」】交付01_总目录.md、02_检测算法分类.md、03_溯源技术与实践.md。
本章汇总全景调研的核心结论、当前技术/治理的风险与分歧、以及信息缺口与下一步建议。
一、核心结论
- 检测的本质是「找生成痕迹」:无论生成多逼真,生成过程必然在空间(GAN 伪影/像素统计)、时域(闪烁/眨眼/口型同步)、频域(频谱指纹)、生理信号(心率 PPG)留下不一致痕迹。检测算法就是放大并识别这些痕迹。
- 检测模型从单帧走向多模态:从传统 CNN 单帧分类(Xception 等)演进到时空模型(3D-CNN/Video Transformer)、视觉-音频多模态融合、以及针对扩散模型的生成式反向检测。跨数据集/跨生成器泛化仍是公认痛点。
- 溯源与检测是两种互补范式:检测是「事后被动识别真假」,溯源是「事前主动标记 + 事后归属」——靠 C2PA 内容凭证、不可见水印、生成模型指纹、元数据/编码取证、发布链路分析。
- 监管已从「倡导」走向「强制标识」:中国《人工智能生成合成内容标识办法》(2025-09 施行)要求 AI 生成内容显式+隐式标识;国际 C2PA 联盟、欧盟 AI Act、美国多州立法同步推进。
- 攻防是动态博弈:生成器升级(扩散模型/多模态大模型)使旧检测特征失效,水印可被擦除,溯源依赖生成方配合——没有一劳永逸的解决方案。
二、风险与分歧
| 风险/分歧 | 说明 |
|---|---|
| 泛化难题 | 检测器在训练集 AUC 高,跨数据集/跨生成器显著下降 |
| 对抗鲁棒性 | 对抗扰动可使检测器失效 |
| 水印可擦除 | 裁剪/重压缩/重编码/对抗扰动破坏水印与元数据 |
| 溯源依赖配合 | 开源/本地模型不写凭证,溯源无从谈起 |
| 误伤与隐私 | 误标真实内容、过度溯源侵犯创作者权益 |
| 实时性 | 实时换脸诈骗要求检测实时,算力/延迟是工程瓶颈 |
| 监管落地难 | 标识办法依赖平台执行,开源生态与境外内容难覆盖 |
三、信息缺口(诚实标注)
- 各检测算法在**真实世界(非基准数据集)**上的准确率缺乏统一、可复现的第三方评测。
- 扩散模型/多模态大模型生成内容的检测与溯源研究仍在快速演进,结论时效性强,需持续跟踪。
- 具体平台(YouTube/Meta/TikTok)的实际标注执行率与水印保留率缺乏公开量化数据。
- 韩国 Deepfake 事件等具体案例的检测/溯源处置细节未逐一核实,仅作定性背景。
四、下一步建议
- 技术侧:关注「通用伪造检测器(GDFD)」与「扩散模型反向检测」两个前沿方向;建立跨数据集评测基准。
- 治理侧:推动生成工具默认写入 C2PA 凭证 + 不可见水印;平台落实显式/隐式标识并公开执行数据。
- 工程侧:对实时换脸诈骗场景,设计「检测 + 溯源 + 人工复核」的流水线,平衡准确率与误伤。
- 研究侧:补齐真实世界评测、水印鲁棒性对抗、跨平台链路溯源三个缺口。
参考来源(汇总)
- 百度百科「深度伪造」:https://baike.baidu.com/item/深度伪造/56522542
- CSDN《2026 Deepfake 攻防全栈实战》:https://blog.csdn.net/weixin_42376192/article/details/160545818
- 知乎《【无中生有的AI】关于 deepfake 的入门级梳理》:https://zhuanlan.zhihu.com/p/139489768
- 知乎《深度伪造(Deepfake)原理分析及实战》:https://zhuanlan.zhihu.com/p/398578602
- C2PA(内容来源联盟):https://c2pa.org/
- 国家网信办《人工智能生成合成内容标识办法》:https://www.cac.gov.cn/2025-03/14/c_1742916354200000.htm
 微信扫一扫,打赏作者吧~
网友评论